Docker и Kubernetes: в каком порядке изучать начинающему DevOps-инженеру
Kubernetes становится понятнее, когда за ним уже есть опыт работы с контейнерами. Разбираемся, почему Docker стоит изучить раньше и что должно быть между ними.
Docker и Kubernetes часто встречаются рядом в программах DevOps-курсов, вакансиях и технических статьях. Из-за этого легко решить, что их нужно изучать одновременно или сразу начинать с Kubernetes, потому что он кажется более серьёзным и востребованным инструментом. На практике такой путь обычно только усложняет старт.
Kubernetes становится понятным тогда, когда ты уже видел, как приложение собирается в Docker-образ, запускается в контейнере, получает переменные окружения, подключается к базе данных и пишет логи. Без этого опыта кластер быстро превращается в набор YAML-файлов, команд и ошибок, смысл которых трудно связать с реальной работой приложения.
Поэтому для начинающего DevOps-инженера разумнее двигаться последовательно: сначала Docker и локальное окружение, затем несколько связанных сервисов через Docker Compose, после этого базовая автоматизация проверок и только потом Kubernetes. Такой порядок не замедляет обучение — он даёт опору, на которой более сложные инструменты начинают выглядеть логичным продолжением уже знакомых задач.
Почему Docker стоит изучить раньше
Docker помогает упаковать приложение вместе с его зависимостями и запустить его в одинаковом окружении на разных компьютерах. Например, Python-сервису может понадобиться конкретная версия языка, набор библиотек, переменные окружения и база данных PostgreSQL. Docker позволяет описать эту конфигурацию в файлах проекта, а не держать её в виде длинной инструкции в заметках или чате.
Kubernetes работает с контейнеризированными приложениями. Он не отменяет необходимость понимать Docker-образ или команду запуска. Напротив, Kubernetes предполагает, что приложение уже можно собрать, запустить и проверить в контейнере. Если на локальном компьютере сервис не запускается, кластер не сделает проблему проще — он лишь добавит новые уровни, на которых придётся её искать.
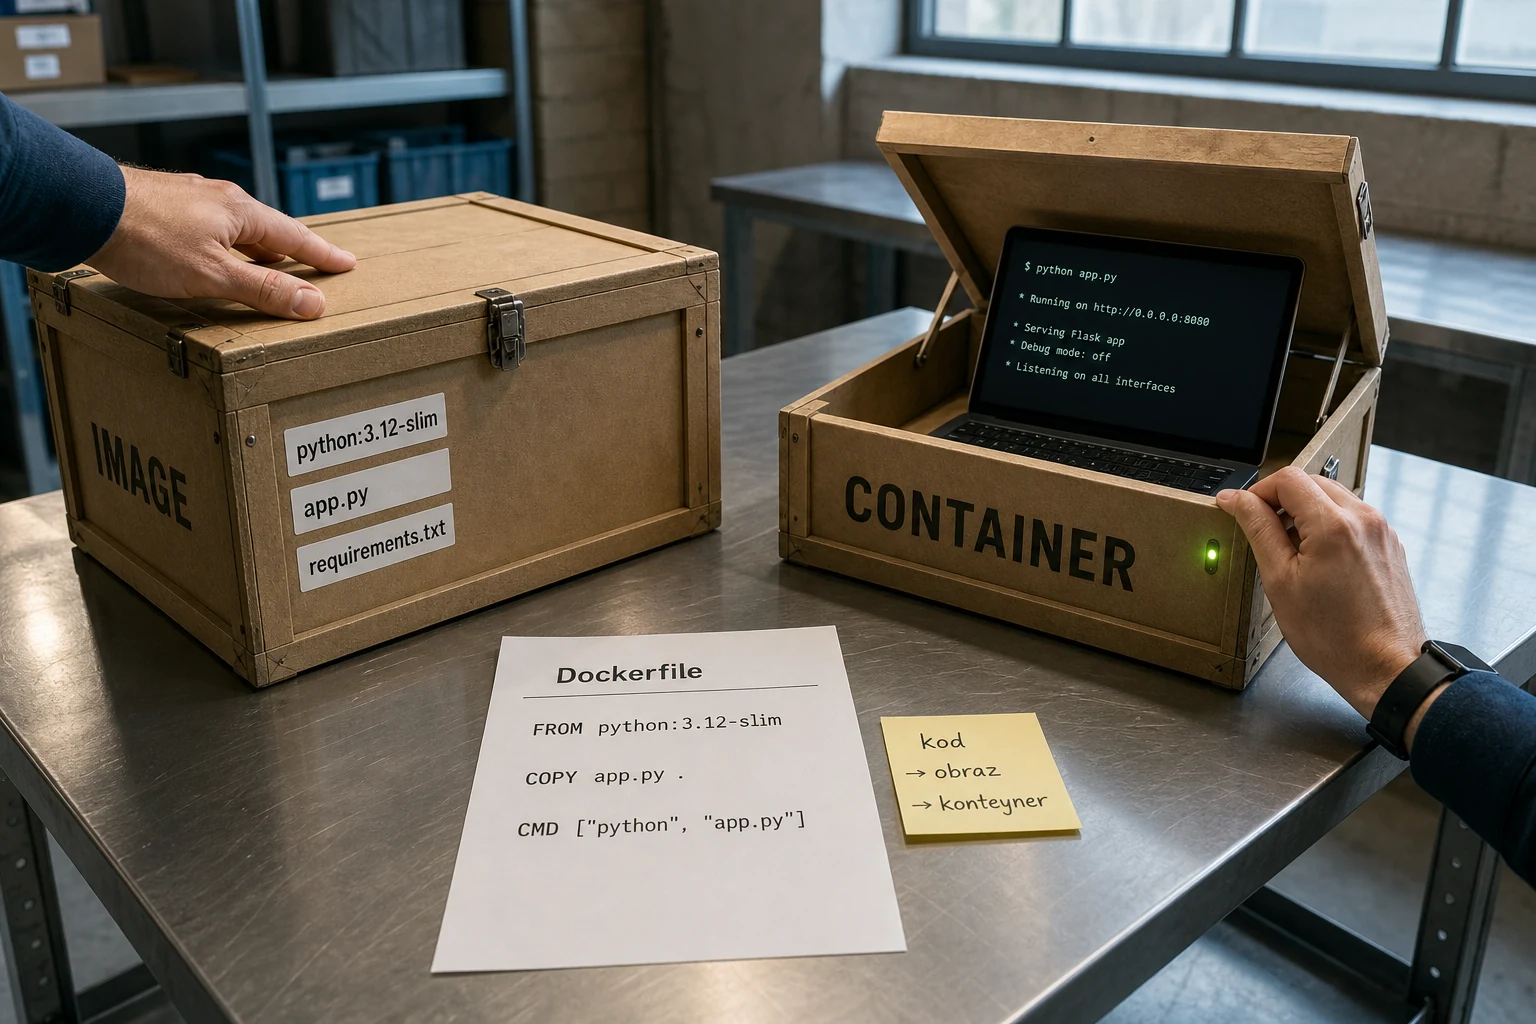
Базовое знакомство с контейнерами можно начать со статьи «Что такое Docker простыми словами». В ней разобрана разница между образом, контейнером и Dockerfile. Эта статья продолжает тему и помогает понять, в какой момент опыт Docker становится достаточной основой для Kubernetes.
Что важно освоить в Docker
Первый уверенный шаг — собрать образ собственного небольшого приложения. Это может быть сервис на Python, простое API или учебное приложение с базой данных. Важно не просто выполнить готовую команду, а понимать, что находится в Dockerfile: откуда берётся базовый образ, как копируются файлы, где устанавливаются зависимости и какая команда запускает приложение.
Затем полезно научиться работать с контейнером во время его запуска. Как передать настройки через переменные окружения? Как открыть порт, чтобы обратиться к приложению из браузера? Где посмотреть логи, если сервис не стартует? Что происходит, если процесс внутри контейнера завершается с ошибкой? Ответы на эти вопросы помогают увидеть контейнер не как закрытую коробку, а как рабочее окружение программы.
Следующий уровень — Docker Compose. Он позволяет описать несколько связанных сервисов в одном файле. Например, приложение может запускаться вместе с PostgreSQL и Redis. Такой сценарий особенно полезен для обучения: ты видишь, что сервис редко существует сам по себе, а проблема с запуском может быть связана не только с кодом, но и с сетью, настройками, зависимостями или данными в базе.
Также стоит привыкнуть к базовой безопасности. Секреты и пароли не должны попадать в Docker-образ или публичный репозиторий. Важно понимать разницу между конфигурацией, которая относится к проекту, и чувствительными значениями, которые передаются отдельно. Это небольшая, но важная часть инженерной культуры.
Когда Kubernetes перестаёт быть преждевременным
Переходить к Kubernetes имеет смысл, когда ты уже уверенно запускаешь приложение в Docker и можешь объяснить, что происходит в локальном окружении. Не нужно знать все возможности Docker, но желательно без постоянной подсказки собрать образ, запустить контейнер, посмотреть логи, передать настройки и поднять приложение вместе с базой данных через Docker Compose.
Полезный ориентир — ситуация, когда ты понимаешь причину типичных проблем. Например, почему приложение не видит базу данных, почему порт недоступен снаружи контейнера, почему после изменения кода нужно пересобрать образ или почему сервис завершается сразу после запуска. Если эти вопросы ещё вызывают растерянность, лучше уделить Docker немного больше практики.
Когда основа появляется, Kubernetes начинает решать знакомую задачу на другом масштабе. Вместо одного контейнера на локальном компьютере нужно управлять несколькими экземплярами приложения, распределять конфигурацию, обеспечивать доступ к сервису и поддерживать его работу, если один из процессов завершился. Тогда новые термины уже можно связывать с понятным опытом, а не запоминать отдельно.
Что добавляет Kubernetes
Kubernetes помогает управлять контейнеризированными приложениями в кластере. Он следит за тем, чтобы нужное число экземпляров сервиса было запущено, позволяет обновлять приложение постепенно, распределяет конфигурацию и даёт способы связать разные компоненты между собой.
На первом этапе полезно познакомиться с несколькими основными объектами. Pod — это минимальная единица запуска, в которой работает один или несколько связанных контейнеров. Deployment описывает, какое состояние приложения Kubernetes должен поддерживать: например, сколько экземпляров сервиса должно быть запущено и из какого образа. Service даёт стабильный способ обратиться к приложению внутри кластера.
Позже появятся ConfigMap и Secret для конфигурации, Ingress для входящего трафика, probes для проверки состояния приложения, а также механизмы обновления и отката версий. Однако начинать стоит с одного простого сервиса. Если сразу добавить сетевые политики, сложные шаблоны развёртывания, сервисные сетки и множество внешних компонентов, будет трудно понять, какая часть системы отвечает за конкретную проблему.
Небольшой пример: приложение в Deployment
После того как Docker-образ приложения готов, Kubernetes может получить описание того, как этот образ нужно запускать. Например, Deployment ниже просит поддерживать один экземпляр приложения с определённым именем.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tasks-api
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tasks-api
  template:
    metadata:
      labels:
        app: tasks-api
    spec:
      containers:
        - name: api
          image: example/tasks-api:1.0
          ports:
            - containerPort: 8000
В этом описании Kubernetes получает не набор ручных команд, а желаемое состояние: должен существовать один экземпляр приложения tasks-api, запущенный из указанного образа и слушающий порт 8000 внутри контейнера. Если контейнер завершится, Kubernetes постарается вернуть систему к описанному состоянию и запустить его снова.
Этот пример не является полным руководством по Kubernetes. В реальном приложении понадобятся Service, настройки окружения, проверка готовности и другие элементы. Здесь важно увидеть связь с Docker: Kubernetes не создаёт приложение с нуля, а использует уже подготовленный образ и управляет его запуском.
Где появляется CI/CD
Между Docker Compose и Kubernetes полезно добавить базовое понимание CI/CD. Когда разработчик отправляет изменения в репозиторий, автоматическая система может запустить тесты, собрать Docker-образ и сохранить его в реестре образов. После этого Kubernetes получает новую версию приложения и разворачивает её по заранее описанным правилам.
Не нужно сразу строить сложный конвейер с несколькими окружениями и десятками проверок. Для первого опыта достаточно увидеть цепочку: изменение в коде → автоматическая проверка → сборка образа → запуск обновлённой версии. Это связывает инструменты в единый процесс и помогает понять, зачем DevOps-инженеру нужны и Git, и Docker, и Kubernetes.
Понимание Git особенно важно в этой цепочке, потому что код приложения, Dockerfile, конфигурация CI/CD и Kubernetes-манифесты обычно хранятся рядом в репозитории. Если нужно освежить базу, посмотри статью «Что такое Git и зачем он нужен разработчику».
Как практиковаться без лишней сложности
Для первого опыта не нужен платный облачный кластер и не стоит использовать рабочую инфраструктуру как учебный стенд. Достаточно локального окружения, например kind или minikube, и небольшого приложения, которое ты уже умеешь запускать через Docker Compose.
Попробуй пройти один и тот же путь последовательно. Сначала запусти сервис локально без контейнера. Затем собери Docker-образ и подними приложение вместе с базой через Compose. После этого добавь простую автоматическую проверку в репозитории. И только затем перенеси приложение в локальный Kubernetes-кластер через Deployment и Service.
Такая практика помогает увидеть, что технологии не существуют отдельно друг от друга. Docker описывает окружение, Compose связывает сервисы локально, CI проверяет изменения, а Kubernetes управляет запуском контейнеров в кластере. Когда эта связь становится понятной, новые темы вроде конфигурации, мониторинга и масштабирования ложатся намного спокойнее.
Что стоит запомнить
Docker и Kubernetes не конкурируют между собой. Docker помогает собрать и запустить приложение в контейнере, а Kubernetes помогает управлять запуском контейнеризированных приложений в кластере. Поэтому путь от Docker к Kubernetes — не набор случайных технологий, а движение от одного понятного уровня к следующему.
Если ты начинаешь путь в DevOps, сначала освой Linux, Git, Docker и Docker Compose на небольшом сервисе. Затем добавь базовый CI/CD и только после этого переходи к Kubernetes. В треке DevOps Engineer на TeoBrain эти темы выстроены в последовательный маршрут: от командной строки и контейнеров к автоматизации, инфраструктуре, мониторингу и проектной практике.
Об авторе

Обучение и развитие
Словари в Python: как хранить данные по ключу
Почему словарь напоминает карточку объекта и как он помогает работать с заказами, пользователями и …
Что такое командная строка и терминал: базовые понятия для разработчика
Почему текстовые команды остаются удобным способом работать с проектом, даже если есть привычный интерфейс.
Что такое GitHub и чем он отличается от Git
Чем GitHub отличается от обычного хранения файлов и почему аккуратный репозиторий говорит о проекте …
Что такое программирование простыми словами: как компьютер выполняет команды
Как обычная задача постепенно превращается в последовательность команд, понятных компьютеру.
API-тесты и UI-тесты: с чего начать автоматизацию тестирования
API- и UI-тесты проверяют разные уровни приложения. Разбираемся, почему начинать автоматизацию обычно удобнее с …
Типы данных в Python: int, float, str, bool и None
Почему одинаковые на вид значения могут вести себя по-разному — и как это отражается …
Списки, кортежи и множества в Python: в чём разница
Как выбрать способ хранения данных, если важны порядок, возможность изменений или отсутствие повторов.
SQL для аналитика: какие запросы изучать в первую очередь
Аналитику нужен не набор случайных SQL-команд, а умение получать из данных ответ на конкретный …
Ручное тестирование или QA Automation: какое направление выбрать
Ручное тестирование и автоматизация решают общую задачу качества продукта, но требуют разного набора навыков …
Что такое Docker простыми словами: контейнеры для разработки и запуска приложений
Зачем разработчикам описывать окружение проекта так же внимательно, как и сам код.